HTTrack est un très bon logiciel. Il réplique des sites web depuis 1998, il est gratuit, et sur un site construit comme on les construisait en 1998 il fonctionne parfaitement.
Les plateformes no-code modernes ne sont pas construites ainsi. Si vous avez pointé HTTrack vers une URL Framer, Webflow, Wix ou Squarespace et récupéré un dossier qui s'affiche en page blanche, en mur de texte sans style, ou avec tous les points de rupture empilés, voici pourquoi — et cela ne se règle pas avec une autre option.
La version en une phrase
HTTrack enregistre le HTML envoyé par le serveur. Votre navigateur affiche le HTML construit ensuite par JavaScript. Sur un site no-code ce sont deux documents différents, et le seul intéressant n'existe qu'en mémoire.
Ce que fait réellement HTTrack
HTTrack est un client HTTP doublé d'un analyseur de liens. Pour chaque URL :
- Il demande l'URL et enregistre le corps de la réponse
- Il y cherche les attributs
hrefetsrc - Il met en file ce qu'il trouve et recommence
C'est tout le modèle. Il n'exécute jamais une ligne de JavaScript, car il ne contient pas de navigateur. Pas de DOM, pas de moteur de rendu, aucune idée de l'apparence de la page.
Pour un site statique cela suffit : la réponse du serveur est la page. Pour un site rendu en React, on en est loin.
Ce que cela vous coûte concrètement
Le CSS de mise en page manque
C'est celui qui produit « tous mes points de rupture s'affichent en même temps ».
Framer livre les variantes responsive sous forme de sous-arbres DOM distincts, masqués et révélés par des règles @media qui vivent dans un bloc <script id="__framer__breakpoints"> ou dans un attribut data-framer-hydrate-v2 — en JSON, pas en CSS. Un navigateur exécute ce script et les bonnes règles sont injectées. HTTrack copie la balise comme du texte et s'arrête là.
Résultat : une page où les versions mobile, tablette et bureau s'affichent simultanément, empilées. Le fichier n'est pas cassé ; les règles qui auraient masqué quatre variantes sur cinq n'ont jamais été générées.
Les styles calculés ne se résolvent jamais
Framer applique beaucoup de style visuel à l'exécution : couleurs de fond, rayons de bordure, ombres, filtres d'arrière-plan, typographie. Ces valeurs sont calculées pendant l'hydratation, pas écrites dans le HTML envoyé par le serveur.
HTTrack capture le balisage d'avant hydratation : ces éléments arrivent donc sans aucun style. Vous obtenez le bon contenu, à peu près dans le bon ordre, sans aucune ressemblance avec le site.
Tout ce qui est sous la ligne de flottaison manque
La plupart des plateformes no-code chargent les images en différé, et beaucoup chargent des sections entières au défilement. HTTrack ne défile pas, car il n'a pas de fenêtre d'affichage. Les images qui attendaient un IntersectionObserver ne sont jamais demandées, donc jamais découvertes, donc jamais téléchargées.
Idem pour tout ce qui se cache derrière un bouton Charger plus, un onglet ou un accordéon. Si un clic le révèle, HTTrack ne le trouvera pas.
Vous embarquez les déchets de la plateforme
HTTrack copie fidèlement — y compris le badge « Made in Webflow », le runtime Thunderbolt de Wix, les balises d'analytique et les scripts de suivi injectés par la plateforme. Vous conservez chaque kilo-octet de surcharge que vous vouliez justement laisser derrière.
Il y a un effet secondaire. Le runtime Wix démarre un Worker depuis l'origine du site d'origine. Dès que vous hébergez la copie ailleurs, cette requête devient cross-origin et échoue avec une SecurityError avant l'hydratation. Le fichier copié n'est pas seulement lourd : le runtime resté à l'intérieur le casse activement.
Les liens pointent toujours vers l'ancien domaine
HTTrack réécrit les URL qu'il a découvertes. Tout ce qui est construit en JavaScript — liens de routeur, sources d'images générées, tout ce qui est assemblé depuis un gabarit — continue de pointer vers le domaine copié. Le miroir paraît autonome jusqu'au premier clic, qui vous renvoie sur le site d'origine.
Pourquoi « mets une option plus large » ne suffit pas
Le conseil habituel : --mirror, plus de profondeur, un délai plus long. Rien de tout cela ne change le résultat, car la limite est architecturale et non configurable. Aucune profondeur ne fera exécuter React à un client HTTP. wget --mirror, curl, Enregistrer sous et les extensions qui exportent document.documentElement.outerHTML se heurtent toutes à une version du même mur.
Enregistrer sous s'en approche le plus, car il y a un vrai navigateur derrière, mais il capture une seule page, conserve le runtime de la plateforme et ne réécrit pas les liens internes pour un usage hors ligne.
Ce que fait un exportateur qui rend la page
L'alternative consiste à piloter un vrai navigateur et à enregistrer ce qu'il a dessiné. C'est l'approche de NoCodeExport :
- Charger la page dans un vrai navigateur, puis attendre le signal d'hydratation propre à la plateforme plutôt qu'un minuteur fixe
- Parcourir toute la hauteur de la fenêtre, ce qui déclenche le chargement différé et les IntersectionObserver, et cliquer sur les boutons Charger plus
- Attendre le décodage des polices, images et vidéos
- Relire les styles calculés et les inscrire sur les éléments concernés, pour qu'ils survivent au retrait du runtime
- Reconstruire le CSS des points de rupture en vraies règles
@media, pour qu'une seule variante s'affiche - Et alors seulement sérialiser le DOM : celui construit par le navigateur, pas celui envoyé par le serveur
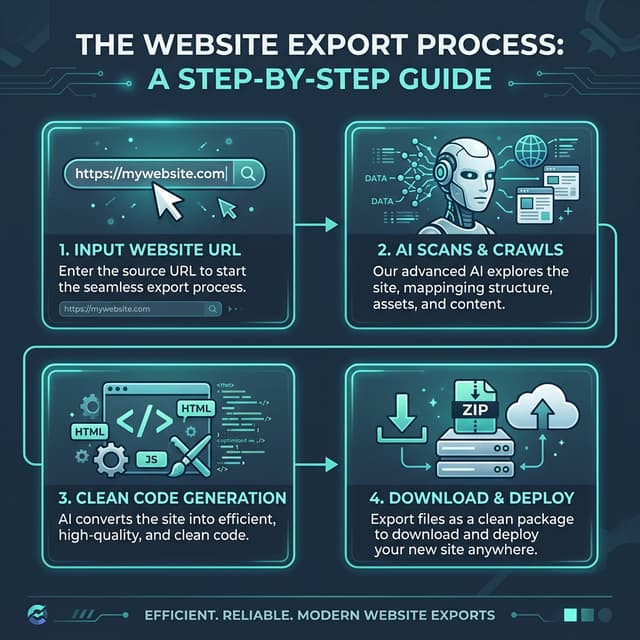
Ensuite c'est un problème de site statique classique : réécrire les liens en chemins relatifs, retirer traqueurs et badges, télécharger les médias et empaqueter le tout.
Les parties interactives sont traitées à part. Sliders, onglets, accordéons et animations au défilement dépendent du runtime qu'on vient de retirer : ils sont réimplémentés en quelques kilo-octets de JavaScript natif. C'est pour cela qu'un export peut se passer du runtime Webflow tout en gardant des onglets fonctionnels.
Quand HTTrack reste le bon outil
Il n'a pas cessé d'être utile :
- Sites rendus côté serveur : WordPress sans constructeur lourd, HTML brut, la plupart des sites de documentation. La réponse du serveur est la page, donc HTTrack récupère tout.
- Crawls d'archivage où l'on veut les réponses brutes plutôt qu'une copie fonctionnelle.
- Tout ce qui doit tourner hors ligne, scripté et à grande échelle, sur des sites que vous savez statiques.
Si le site a été fait dans Framer, Webflow, Wix ou Squarespace, c'est le mauvais outil — non parce qu'il est ancien, mais parce qu'il résout un autre problème.
Comment le copier correctement, étape par étape
- Vérifiez que la page est construite dans le navigateur. Ouvrez le site, clic droit, choisissez Afficher le code source de la page, puis cherchez un titre que vous voyez à l'écran. S'il n'est pas dans la source, c'est JavaScript qui l'a inséré — et HTTrack ne le trouvera pas non plus.
- Exportez depuis l'URL publiée. Collez l'URL en ligne dans un exportateur qui rend la page. Il la charge dans un vrai navigateur, attend l'hydratation, fait défiler pour déclencher le chargement différé, puis sérialise le DOM construit par le navigateur.
- Choisissez le traitement des ressources. Les ressources téléchargées entrent dans le ZIP et rendent la copie autonome. Les ressources en hotlink restent sur le CDN d'origine et exigent que le site source reste en ligne.
- Servez le dossier et vérifiez-le. N'ouvrez pas
index.htmlpar double-clic : les navigateurs bloquent les modules enfile://. Lanceznpx servedans le dossier, puis regardez la console, l'onglet Network pour les 404, et redimensionnez la fenêtre pour confirmer qu'un seul breakpoint s'affiche. Instructions complètes ici.
Essayez sur votre propre site
Le plus rapide est de lancer les deux sur la même URL et d'ouvrir chaque résultat. Collez votre site dans l'exportateur de code web et comparez avec votre miroir HTTrack.
Si vous venez d'une plateforme précise, ceux-ci détaillent ce qui survit à un export :